Herunder angives en model for computerens arbejdshukommelse til anvendelse i fagene Programmering C og B. Modellen tilstræbes så simpel, at den er anvendelig for nye programmører. Noten findes også som original PDF.
Arbejdshukommelse i computer 🔗
Applikationer og operativsystem anvender computerens arbejdslager, også kaldet RAM. Når programmer kører, opstår behov for lagring af selve programmet og de data, programmet arbejder med, i RAM.
RAM står for Random Access Memory og indikerer, at vilkårlige (random) steder i hukommelsen kan tilgås direkte — i modsætning til magnetbånd, hvor båndet skal spoles frem eller tilbage, før man kan tilgå data. Moderne computere er i skrivende stund typisk udstyret med 8GB eller 16GB RAM.
Arbejdshukommelsen må ikke forveksles med harddiskens lager, som typisk er 256GB eller mere. Sammenlignet med at skrive til og læse fra en harddisk er arbejdshukommelsen meget hurtigere, selvom forskellen er blevet mindre de senere år med udbredelsen af SSD-harddiske.
Nu er vi klar til at opstille en model for computerens arbejdshukommelse.
En model for arbejdshukommelsen 🔗
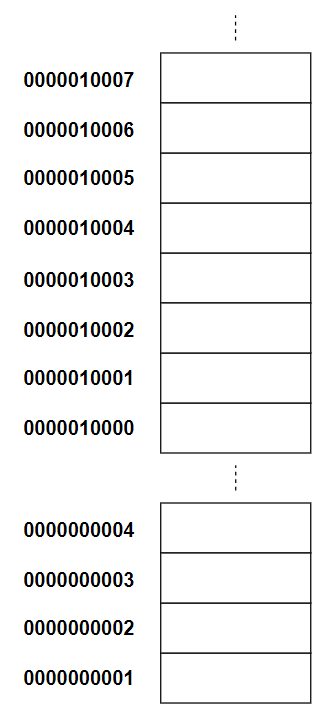
Arbejdshukommelsen er opdelt i en række rum. I computere arbejder den mindst mulige lager-enhed med to mulige tilstande, slukket eller tændt. Det gør man også i det binære talsystem, som kun har to cifre, 1 og 0. Et binært ciffer kan altså være enten 1 eller 0. Vi benævner den mindst mulige lager-enhed for bit fra det engelske ”binary-digit”.
Computere har så bare rigtig mange bits i deres arbejdslager, f.eks. cirka 8 milliarder bits i et 8GB RAM-lager. I stedet for at anvende hver enkelt bit for sig tilgår man oftest lageret i klumper af 8bit (her kaldet en byte, 1 byte = 8bit), 16bit, 32bit eller 64bit. Det er relateret til, når vi anvender et 32bit- eller 64bit operativsystem.
I den aktuelle model for arbejdshukommelsen vælger vi, at der kan være en byte i hver lagercelle.
Tallene til venstre for hver celle kaldes en adresse — men bliver også ofte kaldt en reference eller en pointer. Man kan sige, at adressen gør det muligt at udvælge en lagercelle. Når processoren ønsker at anvende en lagercelle, foregår det ved, at den vælger hvilken adresse der skal være aktiv, svarende til hvilken skuffe der skal åbnes, hvorefter den kan skrive til eller læse fra lagercellen.
Lagring af data 🔗
Lagring af en byte
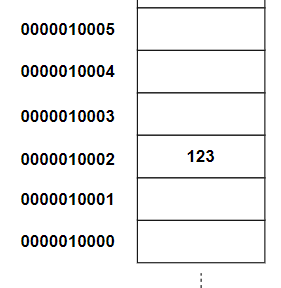
En byte kan indeholde tallene fra 0 til og med 255. Lad os sige, at vi ønsker at gemme tallet 123 i lagercellen med adressen 0000010002. Da tallet kan være i en byte, vælger vi at lagre det som data-typen ”byte”. Det foregår lynhurtigt i følgende trin:
- Først sætter processoren den aktive adresse til 0000010002.
- Dernæst kopieres tallet 123 til lagercellen.
Lagring af heltal
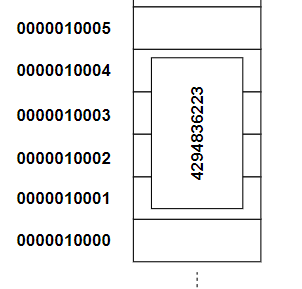
Et heltal lagres normalt ved at anvende 4 byte. Lad os sige, at vi ønsker at gemme tallet 4294836223 i lagercellen med adressen 0000010001. Tallet kan ikke være i en byte (0-255), og vi vælger derfor data-typen ”heltal”, som fylder 4 byte. Lagring foregår lynhurtigt i følgende trin:
- Først sætter processoren den aktuelle adresse til 0000010001.
- Dernæst kopieres tallet 4294836223 til lagercellen.
Bemærk: Da data-typen heltal optager 4 byte, lagres værdien ”henover” 4 lagerceller (hver på 1 byte).
Lagring af kommatal
Kommatal kan lagres med forskellig præcision. Jo flere bytes der anvendes, jo større
præcision. F.eks. arbejder C#-sproget med float (4 byte), double
(8 byte) og decimal (16 byte).
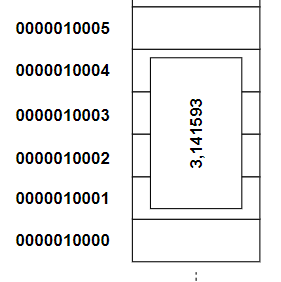
Lad os sige, at vi ønsker at gemme tallet 3,141593 som et kommatal af data-typen
float i lagercellen med adressen 0000010001. Det foregår lynhurtigt i
følgende trin:
- Først sætter processoren den aktuelle adresse til 0000010001.
- Dernæst kopieres tallet 3,141593 til lagercellen.
Da et kommatal af typen float optager 4 byte, lagres værdien ”henover”
4 lagerceller (hver på 1 byte).
Lagring af et tegn
Et tegn er f.eks. et bogstav fra vores alfabet ’a’, et ’b’, et ’Å’ — eller det kan være et specialtegn, f.eks. ’%’, ’*’, ’+’ m.m. I computeren kan man ”kun” lagre tal, så man har brug for en omsætningstabel, et såkaldt tegnsæt. De første mange år af computerens tidsalder lagrede man tegn i en enkelt byte, dvs. som tal fra 0 til og med 255. Herunder vises uddrag fra ASCII-tegnsættet (for de komplette ASCII-tabeller, se ASCII-tabellen):
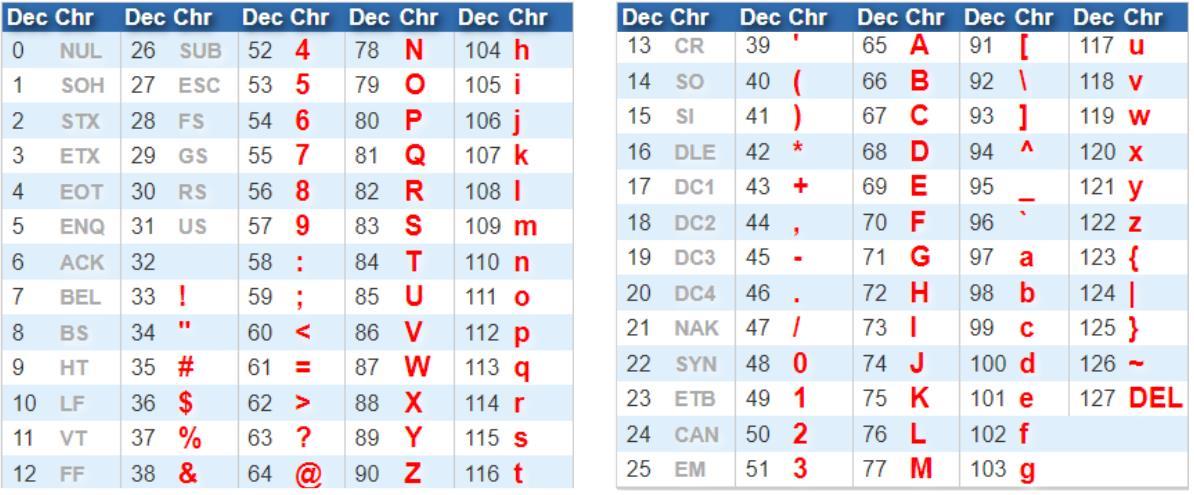
For at lagre et ’a’ i hukommelsen anvendes talværdien 97. For at lagre et ’A’ anvendes talværdien 65. For at lagre et ’Æ’ anvendes talværdien 146. Hvilken talværdi skal du anvende, hvis du ønsker at gemme et @-tegn?
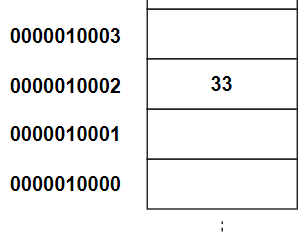
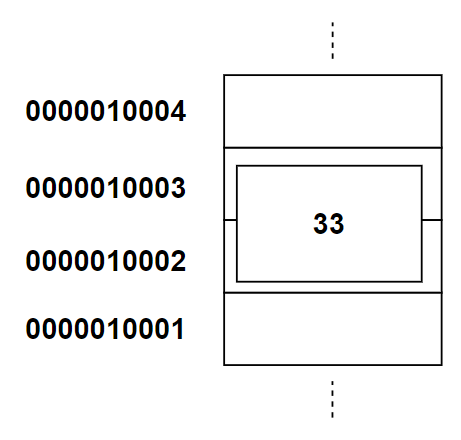
Lad os sige, at vi ønsker at gemme et udråbstegn (!) i lagercellen med adressen 0000010002. Det foregår lynhurtigt i følgende trin:
- Først sætter processoren den aktuelle adresse til 0000010002.
- Dernæst kopieres tallet 33 til lagercellen.
Et problem med ovenstående er, at ASCII-tabellen kun kan rumme et lille antal alfabeter.
Dermed får man problemer med deling af tekstdokumenter internationalt. Derfor opfandt man
Unicode og UTF-8. Unicode og UTF-8 er store tegnsæt, som vi ikke kommer nærmere ind på her.
Det eneste, vi skal vide, er, at C# anvender 16-bit, dvs. 2-byte, Unicode til lagring af
tegn i data-typen char. Vi forbedrer dermed vores model af lagring af et
udråbstegn (!) i C# til:
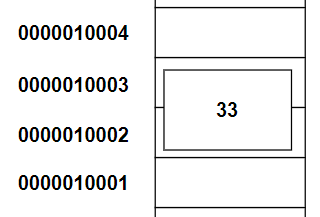
Læg mærke til, at tegnet nu fylder to byte.
Opsummering — to pointer 🔗
Pointe 1: Når vi lagrer noget i hukommelsen, f.eks. tallet 33, så gør computeren det ved at anvende en adresse til at pege på en lagercelle, hvorefter den kan overføre tallet 33 til den aktive lagercelle. For korrekt anvendelse af det lagrede skal vores program vide, hvilken datatype der er lagret i den aktuelle celle.
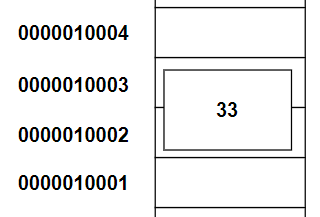
Er det et heltal, en byte, tegnet ’!’ eller noget helt andet?
Pointe 2: Lagring af data og kendskab til datatype skal følges ad! Et lagret tal har ingen betydning, før vi også kender datatypen.
Variabelnavne i stedet for adresser 🔗
Af flere grunde er det meget besværligt at arbejde med adressernes talværdier, såsom 0000010002, når der skrives computerprogrammer. Langt de fleste programmeringssprog gør det også muligt helt at undgå adresserne — og anvender i stedet variabelnavne. Nu hvor vi kender de underliggende mekanismer, kan vi simplificere vores hukommelsesmodel yderligere. Vi gør det i tre trin:
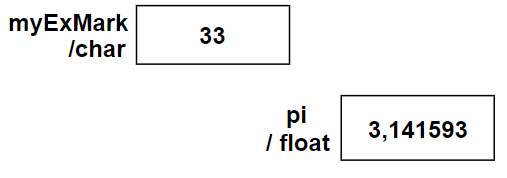
Trin 1: Dels ved at undlade adresserne og i stedet tilføje variabelnavn og
datatype. Til højre har vi brugt variablen med navnet myExMark, som har
data-typen char.
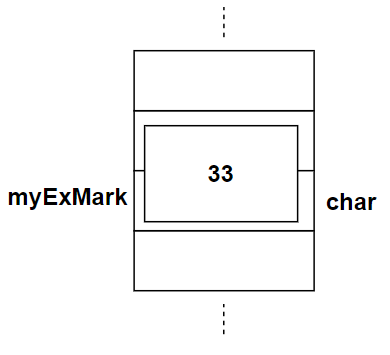
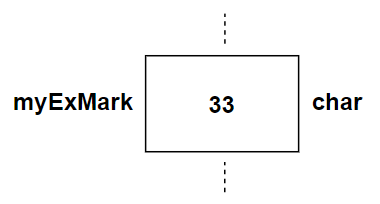
Trin 2: Vi undlader, hvor mange byte de enkelte datatyper anvender, og får resultatet til højre.
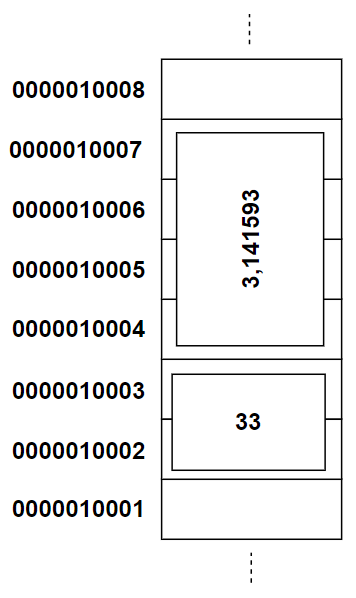
Trin 3: Vi går væk fra princippet om, at lagercellerne skal ligge på en
lang akse, nede fra og opefter. I stedet kan lagercellerne placeres frit, se eksemplet til
højre. I eksemplet anvender programmet variablen myExMark af data-typen
char, og programmet anvender variablen med navnet pi af
data-typen float.
Værdi-datatyper og reference-datatyper 🔗
Alle moderne programmeringssprog anvender direkte eller indirekte begreberne værdi-datatyper og reference-datatyper. C# arbejder direkte med begreberne. Men hvad betyder det i forhold til vores hukommelsesmodel?
Værdi-datatyper
Værdi-datatyper (eng: value types) indeholder selv data. I C# gælder det for
datatyperne int, float, double, decimal,
bool, char, enum, struct og
tuple (avanceret: det gælder også, hvis de gøres ”nullable”).
Værdi-datatyper kaldes også værdi-datatyper, fordi deres værdi kopieres, når man anvender tildeling med lighedstegnet. Eksempel:
int a, b;
a = 2; b = 3;
a = b;
Her kopieres værdien i b til a, så a til slut indeholder værdien 3.
Reference-datatyper
Reference-datatyper (eng: reference types) indeholder ikke selv data, men indeholder
i stedet en reference (dvs. hukommelsesadresse), der peger på, hvor de egentlige data er
lagret. I C# gælder det for datatyperne string, array,
list, object, class, interface,
delegate, record og dynamic.
Reference-datatyper kaldes reference-datatyper, fordi deres reference (adresse) kopieres, når man anvender tildeling med lighedstegnet. Eksempel:
string str1, str2;
str1 = new string("Tekst1");
str2 = str1;
Her kopieres adressen, som str1 peger på, over i str2.
Hukommelsesmodel for string (tekst) 🔗
De eksempler, vi har set på i vores hukommelsesmodel indtil nu, har alle været
værdi-datatyper. Nu viser vi et eksempel med to strenge, dvs. tekst. C# gemmer strenge/tekst
i data-typen string, som er en reference-datatype. Herunder vises model for
lagring af to string-variable, som henholdsvis er lagret på adressen 0000010002 og på
adressen 0000010006.
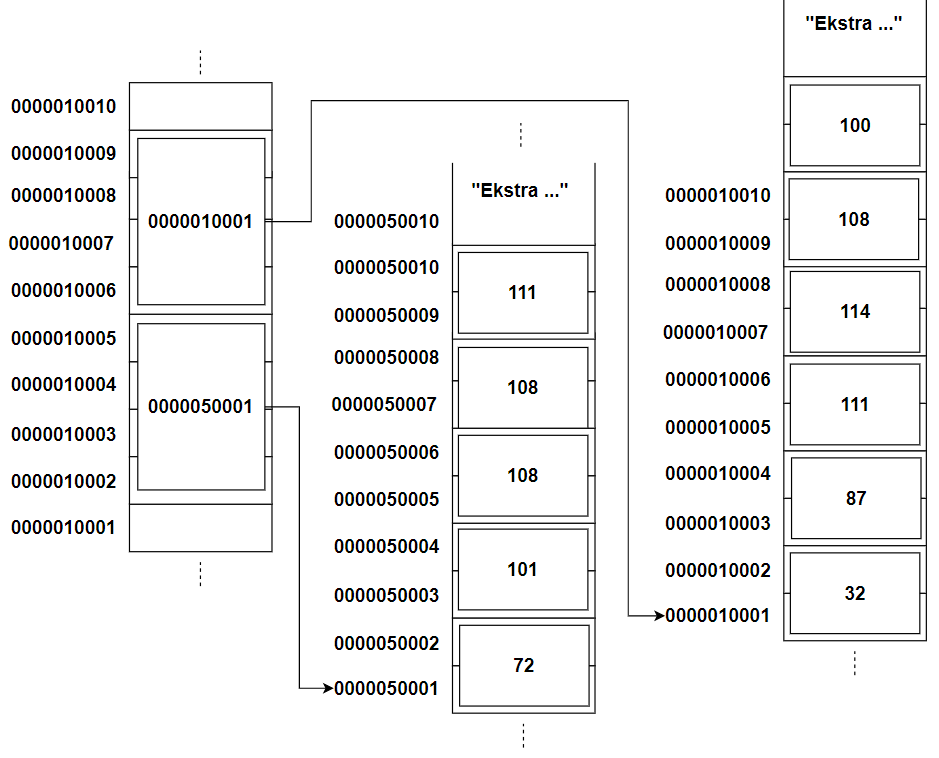
Ovenstående, noget avancerede udgave af vores hukommelsesmodel, viser, at variablene for
strengene, i søjlen til venstre, i virkeligheden ikke indeholder strengene, men kun indeholder
adresser på, hvor strengene faktisk er lagret. I C# er data-typen string i
virkeligheden en klasse. Instanser af string er dermed objekter. Med objekterne
følger der, ud over tegnene i strengen, ”noget ekstra”, som vi ikke kommer ind på her, men
det er vist ovenfor med ”Ekstra …”.
Kan du finde ud af, hvilken tekst de to strenge indeholder?
Simplificeret hukommelsesmodel for tekst (string)
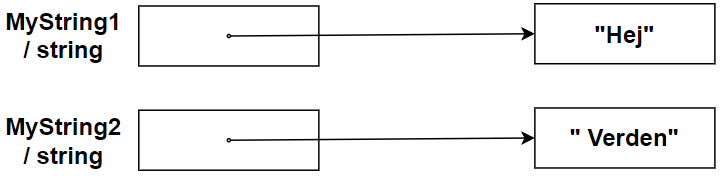
Her vises en simplificeret model af lagring af to string-variable i C#. Adresserne er igen udeladt og erstattet af variabelnavne. Variablenes indhold, adresser, er erstattet af pile, som peger på andre lagerceller, hvor den egentlige tekst er placeret. Lagring af de to strenge foregår i to trin.
Trin 1: Først erklæres de to variable MyString1 og
MyString2, begge af data-typen string. MyString1 og
MyString2 er lagerceller, der kan pege på adresser i hukommelsen.
Trin 2: Dernæst, når streng-variablene tildeles en værdi, foregår det ved,
at tegnene i strengen lagres et andet sted i hukommelsen, hvorefter MyString1
og MyString2 sættes til at pege på, hvor strengene faktisk er.
Opsummering — værdi- og reference-datatyper i modellen 🔗
Herunder vises eksempel med en blanding af datatyper.
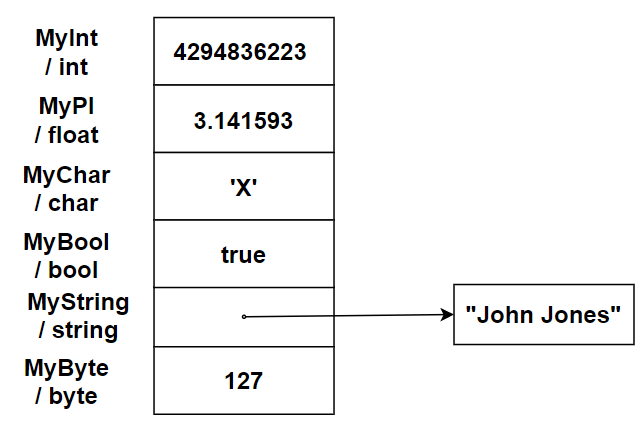
Læg mærke til, at værdi-datatyperne indeholder data selv, mens reference-datatypen, her en
string, indeholder en adresse, en pil, der peger på et andet sted i lageret,
hvor data opbevares.
C#-kode og hukommelsesmodel 🔗
Eksempel med værdi-datatyper
I C# kan alle værdi-datatyper erklæres med syntaksen ”<datatype>
<variabelnavn>”, f.eks.:
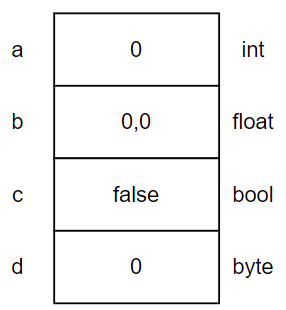
int a;
float b;
bool c;
byte d;
Nu udarbejdes den tilhørende hukommelsesmodel. Hver erklæring af variabel reserverer plads i hukommelsen og ”sætter mærkat”, også kaldet variabelnavn, på hukommelsesområdet. C# sørger desuden for at gemme en ”standardværdi”, også kaldet default-værdi, i lagercellerne. Den resulterende (simplificerede) hukommelsesmodel for ovenstående kode er:
Eksempel med reference-datatype
I C# kan alle reference-datatyper erklæres med tilsvarende syntaks
”<datatype> <variabelnavn>”:
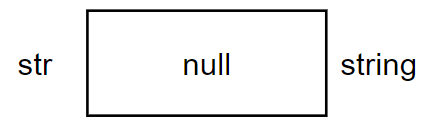
string str;Men her knyttes variabelnavnet til en lagercelle, som kan pege på et område i hukommelsen, men pladsen til data er ikke reserveret i hukommelsen endnu, og lagercellen peger derfor på ”null” — som er begrebet for ikke at pege på noget. Den tilhørende hukommelsesmodel er:
For at reservere hukommelse til en reference-variabels data kan man i C# altid anvende
instruktionen ”new <datatype>()”. Her er eksempel for tekststreng
(string):
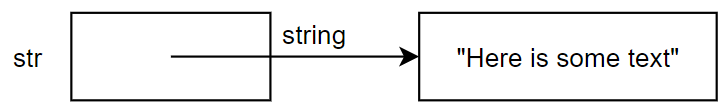
str = new string("Here is some text");
Herved sker der tre ting: (1) der reserveres hukommelse, og (2) teksten ”Here is some text”
kopieres ind i dette lagerområde, og (3) str sættes til at pege på dette
område. Den tilhørende hukommelsesmodel er nu:
Flere reference-variable kan pege på samme indhold. Afvikles f.eks. følgende instrukser:
string str2;
str2 = str;
Så er den tilhørende hukommelsesmodel:
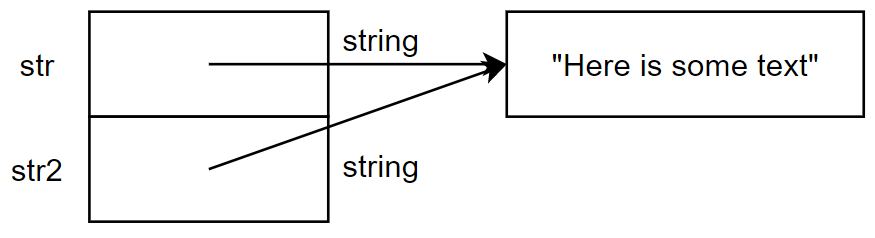
Instruksen str2 = str; har altså blot kopieret adressen i str over
i str2 — og ikke, som man kunne tro, kopieret tekstindholdet til et nyt område
i hukommelsen til str2.
C# og =-operatoren — strenge er immutable 🔗
I C# betyder ”=”-operatoren: læs, hvad der står på højre side, og kopier det ind
i variablen på venstre side. Som vi har set ovenfor, virker denne fortolkning uanset, om det
er værdi-variable eller reference-variable, og som sådan er ”=”-operatoren
relativt simpel.
I C# er string-data-typen immutable. Immutable betyder ”kan ikke
ændres”. Når man alligevel ændrer en tekststrengs indhold, f.eks. ved at sammensætte to
tekststrenge med følgende kode:
str = new string("Hello");
str = str + ", World!";
Da tekstindholdet ”Hello” ikke kan ændres, opretter instrukserne i stedet en ny tekst og sætter
str til at pege på den, som vist herunder:
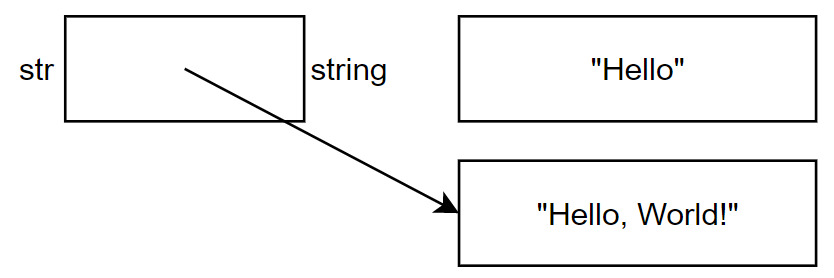
Nu anvendes lageret med ”Hello” i ikke længere, og hurtigt derefter finder Garbage Collectoren ud af at frigive denne hukommelse til anden anvendelse.
Opsummering af C# og hukommelsesmodel 🔗
I det følgende forbindes følgende instrukse-eksempler til data-modellen:
int tal;                      // Erklæring af værdi-datatype
string str;                   // Erklæring af reference-datatype
str = new string("Hello");    // Reference til data i hukommelse
En erklæring af en værdi-datatype-variabel, f.eks. int tal;, gør, at:
- der reserveres plads, dvs. lagerceller, i arbejdshukommelsen med plads til netop denne datatype,
- variabelnavnet knyttes til denne plads i hukommelsen,
- der placeres en værdi i lagercellen; angives ingen startværdi anvendes default-værdien for datatypen, typisk
0, 0.0 eller
false; angives en startværdi anvendes den, - variablen indeholder data.
En erklæring af en reference-datatype-variabel, f.eks. string str;, gør, at:
- der reserveres plads, dvs. lagerceller, i arbejdshukommelsen med plads til en adresse — også kaldet reference eller pointer,
- variabelnavnet knyttes til denne plads i hukommelsen,
- der placeres NULL i lagercellen,
- variablen indeholder en reference — eller NULL, som betyder, at der ikke peges på en plads i hukommelsen (endnu),
- der er endnu ikke reserveret plads til variablens indhold, f.eks. "Hello".
Anvendelse af new, f.eks. str = new string("Hello");, gør, at:
- der reserveres plads, dvs. lagerceller, i arbejdshukommelsen med plads til det aktuelle indhold, her strengen med indholdet "Hello",
- adressen på dette indhold kopieres ind i reference-variablen, her
str.
Bemærk: C# tilbyder ofte simplere måder at reservere plads på end med new, men de
er alle ”genveje” til instruktionen ”new <datatype>()”.
Stak, heap og Garbage Collector 🔗
Når et computerprogram kører, anvender det to områder af hukommelsen forskelligt. Det ene hukommelsesområde kaldes stakken (eng: Stack) og det andet kaldes ”Heap”. Forskellige programmeringssprog anvender de to områder lidt forskelligt, men hovedtrækkene er ens. Her tages udgangspunkt i, hvordan C# anvender områderne.
Bemærk, der er ingen fysisk forskel på de to hukommelsesområder. Den eneste forskel er den måde, programmet anvender områderne på — nemlig til at løse to forskellige problemer. Det vil være for kompliceret at gå nærmere ind på problemerne i denne note; i stedet fokuserer vi på at opstille en simpel model for stakken og for heap'en.
Groft sagt kan vi sige, at instans-variable og statiske variable altid lagres i heap, mens lokale variable typisk lagres på stakken. Eksemplet vist ovenfor vil derfor lagres som vist herunder:
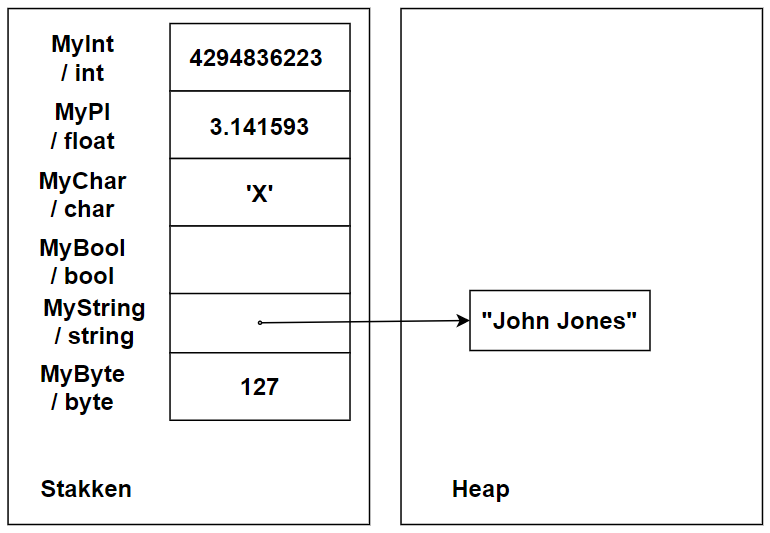
Man kan sige, at heap'en indeholder et tilfældigt virvar af objekter, inklusiv deres variable og statiske variable, og at stakken indeholder en ordnet ”stak” af variable.
Programkode og hukommelsesmodel
Herunder sammenholdes programkode med, hvad der sker i vores hukommelsesmodel. Antag din kode indeholder følgende:
int a;
string str;
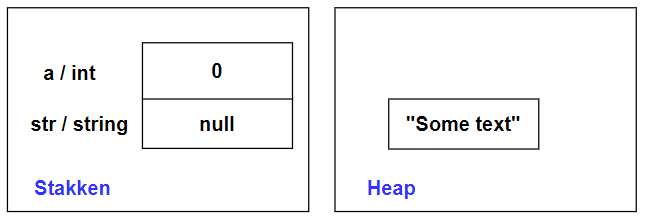
Så sker der følgende i hukommelsen:
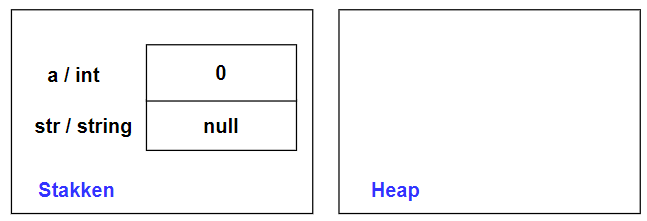
Lidt senere i koden er der følgende instrukser:
a = 33;
str = new string("Some text");
Lidt om Garbage Collectoren i .NET / C#
Garbage Collectoren, GC'en, rydder op i heap'en. GC'en holder øje med, at der fra stakken peges på alle reserverede områder i heap. Hvis man på et tidspunkt mister adressen på noget i heap — f.eks. med koden:
str = null;Så er der ikke længere noget, der peger på ”Some text” i heap'en:
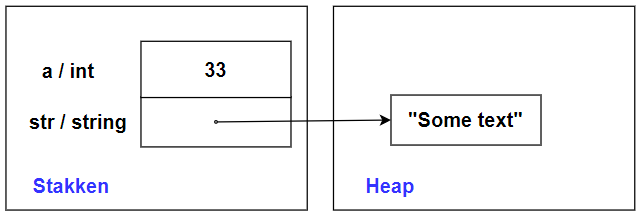
Her går Garbage Collectoren så ind og rydder op på den måde, at lagret, hvor ”Some text” ligger, frigives til anden brug. Det viser vi i vores hukommelsesmodel ved at slette ”Some text” i heap'en:
Man kan ændre, hvad en referencevariabel peger på 🔗
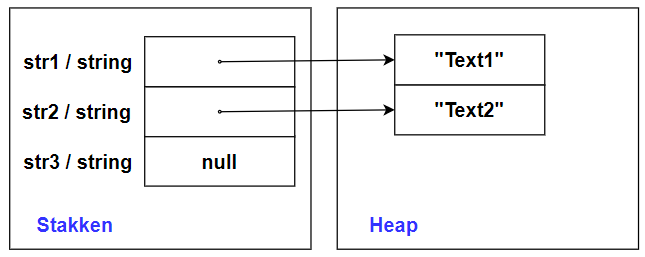
Antag, du har følgende programkode:
string str1, str2, str3;
str1 = new string("Text1");
str2 = new string("Text2");
Efter afviklingen ser hukommelsesmodellen ud som følger:
Dernæst køres instruksen:
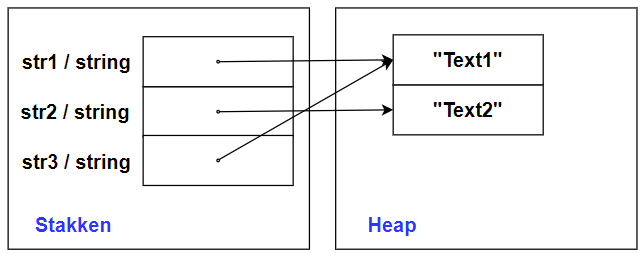
str3 = str1;Hvorved adressen i str1 kopieres over i str3. Nu er hukommelsesmodellen ændret til:
Dernæst køres instruksen:
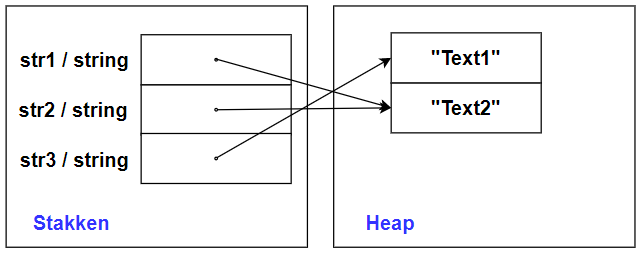
str1 = str2;Hvorved adressen i str2 kopieres over i str1. Nu er hukommelsesmodellen ændret til:
Dernæst køres instruksen:
str2 = str3;Hvorved adressen i str3 kopieres over i str2. Nu er hukommelsesmodellen ændret til:
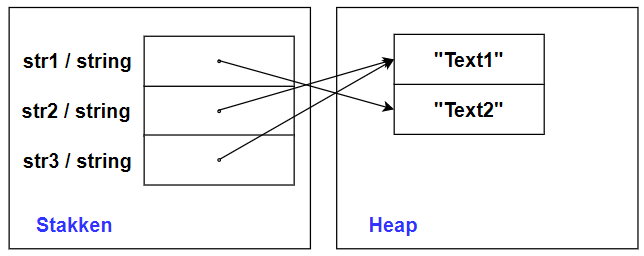
Nu har vi ikke behov for, at str3 peger på noget mere:
str3 = null;Nu er hukommelsesmodellen ændret til:
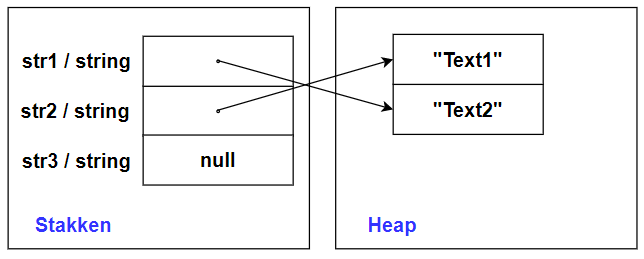
Metoder — parametre, argumenter og stakken 🔗
Vi skal først se lidt på, hvad en metode er. En metode har følgende egenskaber:
- De har et navn, som anvendes til at kalde dem.
- Når man ”kalder” en metode, betyder det, at man kører instrukserne i metoden.
- Metoder kan modtage variable, som lokalt betegnes for metodens parametre.
- Metoder kan desuden have lokale variable, som kan hjælpe metoden til at gøre det, den skal.
- Metoder returnerer en variabel (i C-familien af programmeringssprog klares det med
return-instruktionen).
Bemærk: Forskellige programmeringssprog anvender forskellige navne for ovenstående. Udover navnet metode støder du ofte også på navnene funktion eller procedure.
Stakken og metoder
Stakken (Stack) er det hukommelsesområde, som blandt andet løser problemet med, at metoder skal kunne kalde sig selv, også kaldet rekursion. Man kan derved ikke afsætte et fast område i hukommelsen til anvendelse ved kørsel af en bestemt metode. I stedet gør man følgende:
Når en metode kaldes, oprettes de variable, den arbejder på, på stakken. Man siger, at variable push'es til stakken. Her kan metoden så anvende variablene til at udføre sin opgave. Når metoden er færdig og returnerer, fjernes dens variable fra stakken. Man siger, at variable pop'es af stakken.
Allokering af variablene på stakken sker automatisk; du skal som programmør ikke sørge for dette — det klarer compileren for dig. Lidt teknisk kan man sige, at stakken groft set anvendes som en LIFO (last-in-first-out) datastruktur. Den sidst kaldte funktion skal afslutte, før metoden før den kan afslutte, og så videre.
Eksempel: byt om på to tal — uden ref
Lad os prøve at bytte om på to tal og udskrive dem ved hjælp af en metode. Samtidig opbygger
vi en model af, hvordan stakken anvendes. Først skrives en simpel Main-metode:
static void Main()
{
   int a, b;
   a = 2; b = 3;
}
Variablene a og b er lokale (for Main) og placeres
dermed på stakken. Stak-modellen er vist til højre:
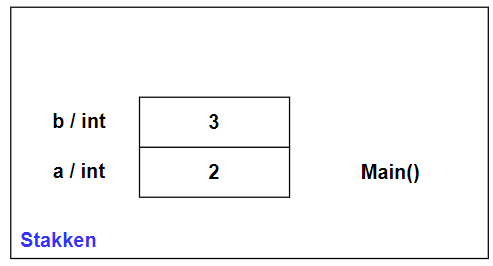
Stakken oprettes nede fra og op. I dette tilfælde er a erklæret først, så den
er placeret på stakken først. Dernæst er b erklæret, så den placeres ovenpå
a.
Nu tilføjes en metode SwapAndDisplay():
static void SwapAndDisplay(int num1, int num2)
{
   int temp;
   temp = num1;
   num1 = num2;
   num2 = temp;
   Console.Write("First number is {0}", num1);
   Console.WriteLine(", and the second is {0}", num2);
   return;
}
I Main-metoden kalder vi ovenstående SwapAndDisplay ved:
static void Main()
{
   int a, b;
   a = 2; b = 3;
   SwapAndDisplay(a, b);
}
Og inden første instruks i SwapAndDisplay er kørt, er vores stak-model følgende:
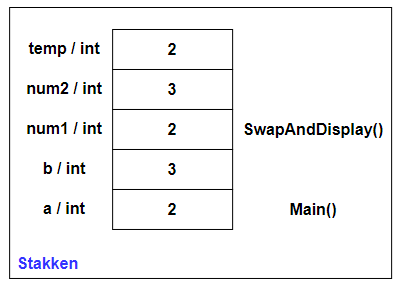
Når SwapAndDisplay() har afviklet instruksen:
temp = num1;Så har den lokale variabel temp fået værdien 2.
Når SwapAndDisplay() har afviklet instruksen:
num1 = num2;Så har den lokale parameter num1 fået værdien 3.
Når SwapAndDisplay() har afviklet instruksen:
num2 = temp;
Så har den lokale parameter num2 fået værdien 2. Og dermed er værdierne byttet
rundt i num1 og num2, og vi kan skrive dem ud:
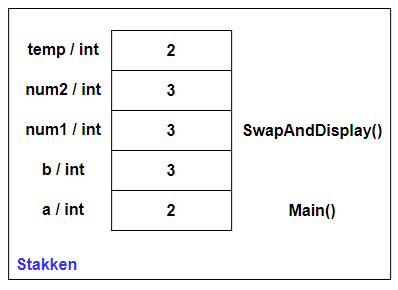
Nu er metoden SwapAndDisplay() færdig og returnerer med instruksen
return;. Derved nedlægges den del af stakken, som blev brugt af
SwapAndDisplay().

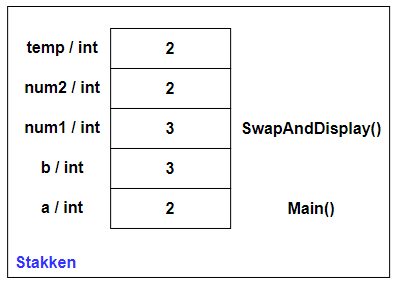
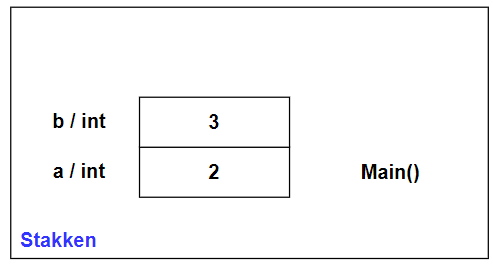
Læg mærke til, at selvom værdierne blev byttet inde i metoden SwapAndDisplay,
så er argumenterne a og b, som blev kopieret til metoden, urørte.
Byt om på to tal — med ref 🔗
Ønsker du at bytte værdierne i a og b, kan det gøres ved at
overføre adressen på a og b i stedet for. Lad os skrive en metode,
som kan bytte om på to tal. Det ændrede program er vist herunder:
static void Main()
{
   int a, b;
   a = 2; b = 3;
   Swap(ref a, ref b);
}

static void Swap(ref int num1, ref int num2)
{
   int temp;
   temp = num1;
   num1 = num2;
   num2 = temp;
   return;
}
Inden kørsel af Swap ser stakken ud som følger:
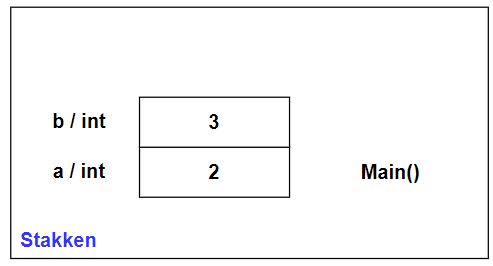
Efter kaldet af Swap, men lige inden første instruks er kørt (i Swap),
ser vores stak-model ud som følger:
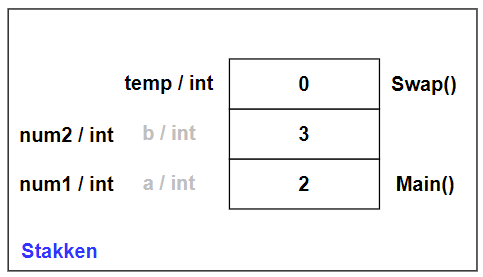
Læg mærke til, at num1 og num2 ikke er nye variable, men blot
referencer til samme sted i hukommelsen som a og b. Den eneste nye
variabel på stakken er temp.
Efter kørsel af:
temp = num1;ser stakken ud som følger:
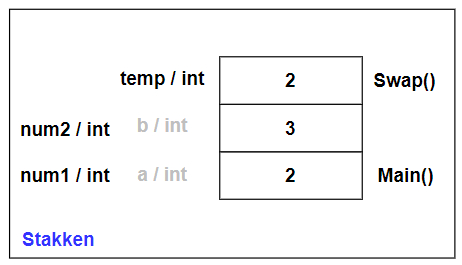
Efter kørsel af:
num1 = num2;ser stakken ud som følger:
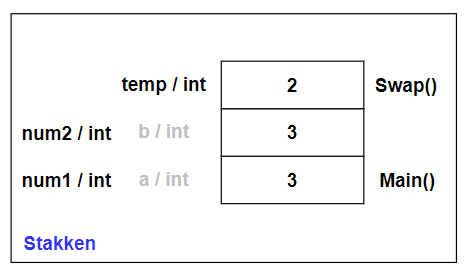
Efter kørsel af:
num2 = temp;ser stakken ud som følger:
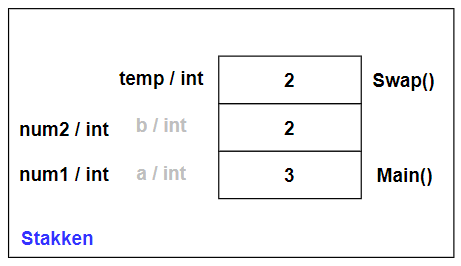
Efter metoden returnerer med:
return;ser stakken ud som følger:
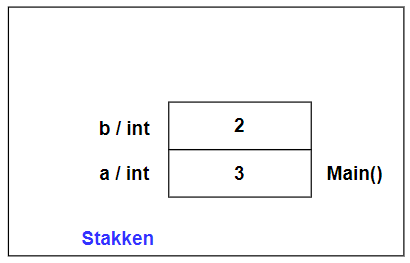
Læg mærke til, at variablene a og b fra den kaldende metode
Main nu er byttet om.
Appendix: ASCII-tabeller 🔗
De komplette ASCII-tabeller findes som opslagsside her: ASCII-tabellen.